Logistic Regression 面试常见考点解析
逻辑回归 (Logistic regression) 是最经典的分类模型,在数据分析和建模领域都有非常广泛的应用。作为一种广义线性模型,logisitic regression与很多机器学习理论知识都有紧密的关联,其中包括我在上一篇文章中讲到的linear regression,以及Generalized Linear Model (GLM) ,softmax regression,neural network 等等。因此,在绝大多数 Data Scientist 和 Data Analyst 面试中,logistic regression都是最重要的理论知识考点。在本文中,我会结合数据岗位面试要求和经典例题给大家精炼梳理logistic regression模型的重要知识点,同时结合它与数据科学领域其他知识点的联系,给大家总结常见面试考点。
1. Logistic Regression概念介绍
我们以一个二分类问题为例,简单回顾一下 logistic regression 的应用场景。以下数据表示某流媒体服务运营商在过去一个季度内,客户月均拨打客服电话的次数 (customer service calls) 与客户在季度末取消订阅行为 (unsubscribe) 的数据关系:

在这个二分类问题中,我们的因变量 (dependent variable)

这种建模方法确实可以直接给出对用户取消订阅的概率预测,比如下图Case1所示的情况:

但是这个模型很容易受到异常数据 (outlier data) 的影响,比如下图Case2所示的情况:当训练数据中包含较多极端情况数据的时候,由 linear regression 方法得到的模型的预测效果会很差 。

出现这个问题的根本原因是:linear regression 的 loss function 均匀地考虑了所有样本距离拟合直线的距离。而要较好地解决这个分类问题,我们需要对 loss function 进行一些“改动”,减弱训练数据里的部分数据对分类决策边界的影响。很明显,这个“改动”应该是一种非线性变换。以下是一种常见的“改动”方法:

从上图可见,经过这个非线性函数的变换,outlier 数据对分类决策边界的影响作用大幅减弱,模型分类效果也变好了。其实,构造类似非线性函数是有很多种不同选择的,在 logistic regression中,研究人员选择了一种有很好的数学性质且表达式简单的函数:logistic function


Notes 1: 从上述讨论中可以看到,这个 logistic function 的数学形式并非来自于严格数学推导证明,而是出自研究人员结合具体需求的近似构造。这个 logistic function 的数学形式也是后文中我们会讲的 logistic regression assumption的一部分。
Notes 2: 这里介绍的从 linear regression 到 logistic regression 的转换思想,也是数据岗位面试的考点之一。常见的面试题目是:解释 linear regression 与 logistic regression 两者的区别和联系。要回答好这个问题,首先可以结合上面几幅图讨论两个模型对 outlier 数据处理的不同效果。此外,可以结合后文会介绍的 Generalized Linear Model (GLM) 内容做细致比较。
现在我们得到了 logistic regression 问题中自变量
2. 从两种不同角度理解 Logistic Regression Loss Function
首先,我们沿用在上一篇Linear Regression文章中提到的最大似然估计方法 ( Maximum Likelihood Estimation) ,结合 logistic regression 的概率假设来推导它的 loss function。
Logistic regression的概率分布假设是 [面试常考点]:
1. The random variable
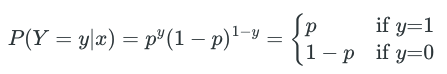
2. There is a linear relationship between the logit of the probability
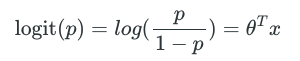
It can also be written as:
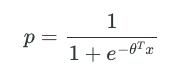
这里提到的 logit function 是 logistic function 的反函数,在后文介绍 Generalized Linear Model 的内容中我们会介绍它们的具体意义。
基于上述概率分布假设,我们通过以下证明过程 (简化版) 推导出loss function [面试考点]:
Given the assumption mentioned above, we can get its probability mass function as
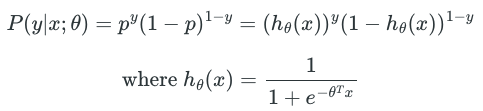
Based on the principal of maximum likelihood estimation, we should choose
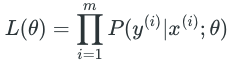
In order to simplify our derivations, we maximize its log likelihood as following: 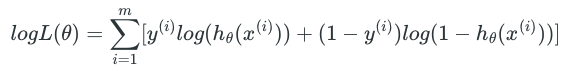
As we can see here, maximizing
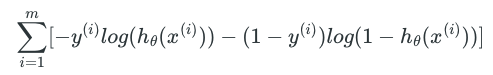
除了利用参数估计方法之外,我们还可以根据交叉熵 (cross entropy) 的概念直接列出 logistic regression loss function。下面我们先介绍一些基本概念:
a. 信息量 (Information Content)
我们利用信息量
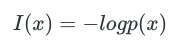
一个事件发生的概率越高,它对应的信息量越小。
b. 熵 (Entropy)
我们把一个随机变量
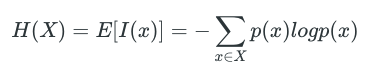
其中
利用交叉熵的定义,我们可以在 logistic regression中定量描述训练数据的分布与拟合分布之间的差异,然后通过最小化这个差异来构造 loss function:
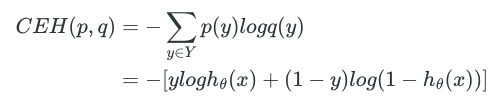
最后通过累加全部训练数据的交叉熵,我们可以得到如下loss function表达式:
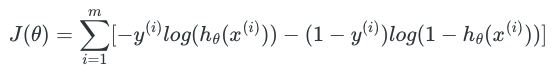
可见这个表达式结论与之前利用概率分布假设推导出来的表达式完全一致。
Notes 1: 上述对 logistic regression loss function的两个不同角度的讨论,也解释了 cross entropy loss 适用于 logistic regression 问题的原因:cross entropy loss 与 logistic regression 的概率分布假设 (Bernoulli distribution & logistic function) 相对应。
Notes 2: 以上我们给出的利用交叉熵定义列出 logistic regression loss function的过程,是一个简化版的推导过程。它的整个描述思路清晰简单,适合在面试中使用。但如果更严格解释的话,其实 logistic regression 构造 loss function时使用的概念是相对熵 (relative entropy),不是交叉熵。在很多资料中,相对熵又被称为KL散度 (Kullback–Leibler divergence)。但由于交叉熵的数学形式更加简单,且与相对熵在取值上只相差一个常数项,因此在绝大多数资料中,我们利用交叉熵的概念来构造 logistic regression loss function。
3. Loss Function数值求解
与上一篇Linear Regression文章中介绍的方法一样,我们使用 gradient descent 数值优化方法求解能使得 loss function
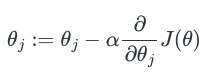
在这里我们省略大部分推导过程,直接给出结论:
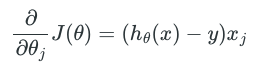
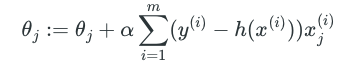
这里我们看到一个“神奇的现象”:logistic regression的模型参数递推公式与linear regression的公式完全一样!
回顾 linear regression loss function数据求解结论:
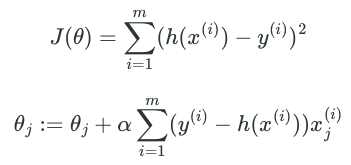
这并不是巧合,而是因为这两个模型都属于Genearlized Linear Model (GLM), 可以被统一的模型框架进行描述,因此它们之间有很多相似的性质。
4. Generalized Linear Model
GLM 涉及的理论内容比较多,且不是面试考察的重点,因此在本文中,我们仅简单介绍 GLM 的一些基本概念,以此解释 linear regression, logistic regression和其他一些广义线性模型 (e.g. softmax regression) 之间的关系。
GLM 的定义包含两部分:
- The conditional distribution
Notes 1: 指数族分布 (Exponential family) 的具体定义比较复杂,我们只需要了解它的几个例子:Normal Distribution, Bernoulli Distribution, Multinomial Distribution都属于Exponential Family。这一系列的函数有诸多好的数学性质,比如它们都有conjugate prior。
Notes 2: 有些资料中是以 link function 的反函数的形式来描述
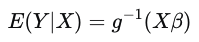
这里
结合上述 GLM 的定义,我们可以从一个新的角度去理解 logistic regression:
相对应地,我们也可以把 linear regression 带入到这个 GLM 框架中:
了解了这部分内容之后,我们就可以更好地回答前面提到的面试题:解释linear regression与logistic regression两者的区别和联系。即我们可以从probability assumptions, GLM link functions等角度进行讨论,这样才是最完整的solution,也最能impress面试官。简单地回答“Logistic regression的label是离散的,linear regression的label是连续的”是远远不够的。
5. 总结
Logistic regression 是数据科学岗位面试中最常见的模型理论知识内容,考点涉及到logistic regression model assumption, loss function推导以及它和其他线性/非线性模型的异同点比较。本文结合面试要求的难度把相关常见考点进行了梳理。除了本文涉及到的内容,logistic regression 也与 neural network 的很多基本概念有密切的关系,比如我们可以把 logistic regression 看做one layer neural network (perception)。其他涉及到的知识点还包括Multi-class classification (Softmax regression), 以及logistic regression在不同变种形式下的正则化方法 (Regularization) 等问题。这些内容我会在后续的Techie面经文章中给大家介绍。感兴趣的同学也可以在Techie论坛中与Techie学员一起讨论。也欢迎扫描下方的二维码或者搜索 TonyCoding20 添加我的微信, 期待和大家的沟通!